
明天你的工厂官网就从AI搜索消失了?9月15日Cloudflare新规+视频GEO+Schema新证,制造业老板必看的3件事
一件明天就生效的事:Cloudflare默认封禁AI爬虫
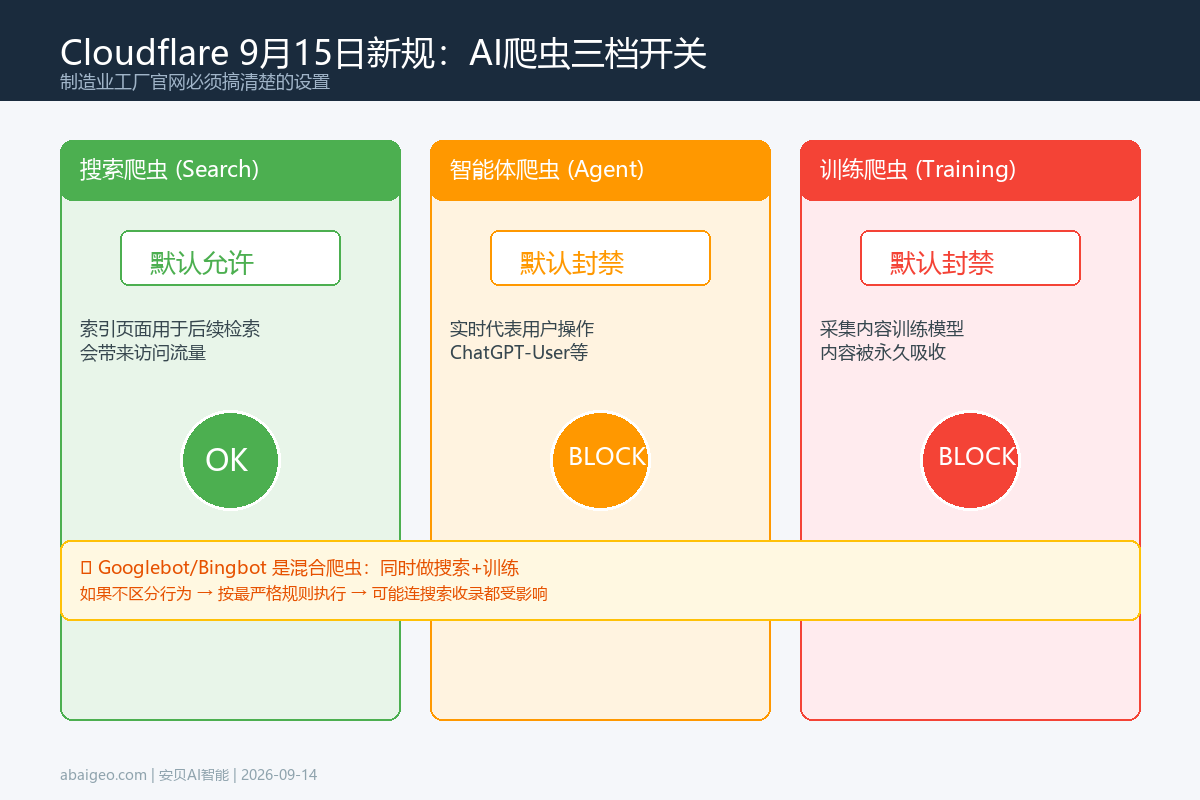
2026年9月15日——也就是明天——全球约22%的网站将迎来一个静默但深远的变化。Cloudflare宣布:即日起,新接入的域名(以及未修改设置的免费版存量用户)将默认封禁AI训练爬虫和智能体爬虫,仅允许传统搜索爬虫通过。
这意味着什么?如果你的工厂官网托管在Cloudflare后面(或者你用的建站公司默认套了Cloudflare),从明天起,豆包、DeepSeek、ChatGPT等AI搜索引擎用来读取你网站的爬虫,可能被默认挡在门外。AI搜索找不到你的工厂信息,自然也不会在采购商提问时推荐你。
更值得警惕的是:Googlebot、Bingbot等”混合用途”爬虫同时承担搜索索引和AI训练两种功能。Cloudflare明确规定,如果一个爬虫不区分搜索和训练行为,将按”最严格规则”执行——即直接封禁。这意味着你的工厂官网可能连Google搜索的收录都受影响。
Cloudflare CEO Matthew Prince的原话:”互联网上超过一半的流量已经来自非人类,旧的内容交换协议已经不可持续。”数据显示,Anthropic的ClaudeBot每爬73000个页面才给网站带回1次访问;Googlebot的比率是5:1。对网站主来说,被AI无限制读取内容、却几乎收不到流量回报,确实是笔亏本买卖。
但对制造业工厂老板而言,真正的关键不是该不该封AI爬虫,而是:你到底有没有检查过自己网站的爬虫设置? 多数工厂官网是建站公司搭建的,Cloudflare、robots.txt等设置往往沿用默认值,你甚至不知道自己的站有没有被Cloudflare保护。如果明天起AI爬虫被封,但你的工厂恰恰需要被AI搜索引用——这个信息差就值真金白银。
工厂老板该做什么:
- 问你的建站公司或IT人员一个问题:”我们网站用不用Cloudflare?AI爬虫设置是什么?”
- 如果用了Cloudflare且不想要默认封禁:进Security设置,把Agent和Training爬虫的开关手动改为允许
- 如果没用Cloudflare:检查根目录robots.txt文件,确认没有屏蔽主流AI爬虫的User-agent
- 核心原则:让”搜索类”AI爬虫能读你的网站,同时不给”训练类”爬虫白嫖内容——Cloudflare的三档开关正好提供了这个选择
第二件事:视频内容正在成为AI可读的GEO资产
9月3日,视频电商平台Videowise发布了一款名为”AI Visibility”的新产品,核心功能是:把TikTok、Instagram上的用户原创视频(UGC)转化为结构化文本,让ChatGPT、Perplexity、Google Gemini等AI引擎可以检索、引用和排名。
这看似是电商领域的新闻,但对制造业工厂同样意义重大。想想看:你工厂的车间实拍视频、产品演示视频、客户到厂参观的短视频——这些原本对AI搜索完全”隐形”的内容,现在可以被AI读取了。
为什么视频一直是GEO的盲区?因为AI搜索引擎本质上是”文本处理引擎”。一个20分钟的车间参观视频,对人类来说信息丰富,但对AI来说——除非有文字描述——就是一堆不可读的像素。YouTube每分钟上传超过500小时视频,但绝大多数没有结构化的文字转写,AI无法提取信息。
Videowise的做法是:逐帧提取视频的音频和画面,用向量视频搜索技术把每个视频转化为AI可读、可引用的结构化内容。这被称为”视频GEO”的新赛道正在打开。
对制造业工厂的实际价值:
| 视频类型 | 传统状态 | 视频GEO后的状态 |
|---|---|---|
| 车间生产实拍 | AI搜不到 | AI可提取工艺参数、产能信息 |
| 产品演示视频 | 仅YouTube可看 | AI回答产品问题时主动引用 |
| 客户参观记录 | 私域素材 | 成为权威信源背书 |
| 技术工艺讲解 | 独立存在 | 转化为FAQ结构化内容 |
工厂老板可以马上做的3步:
- 给每个已发布的YouTube/视频号视频写一份结构化文字转写(不是自动字幕,是人工校对版),包含H2小标题分段
- 在视频落地页嵌入VideoObject结构化数据(标记视频标题、时长、发布日期、完整转写文本)
- 把”结论前置”——视频描述前200字直接写核心结论和关键参数,因为44.2%的AI引用来自页面前30%的内容
第三件事:Schema标记对AI引用的提升,可能没你想的那么大
很长一段时间里,给网站加Schema结构化数据标记(JSON-LD格式)被视为GEO的标配操作。但9月初Search Engine Land发布的一篇分析给出了令人意外的结论。
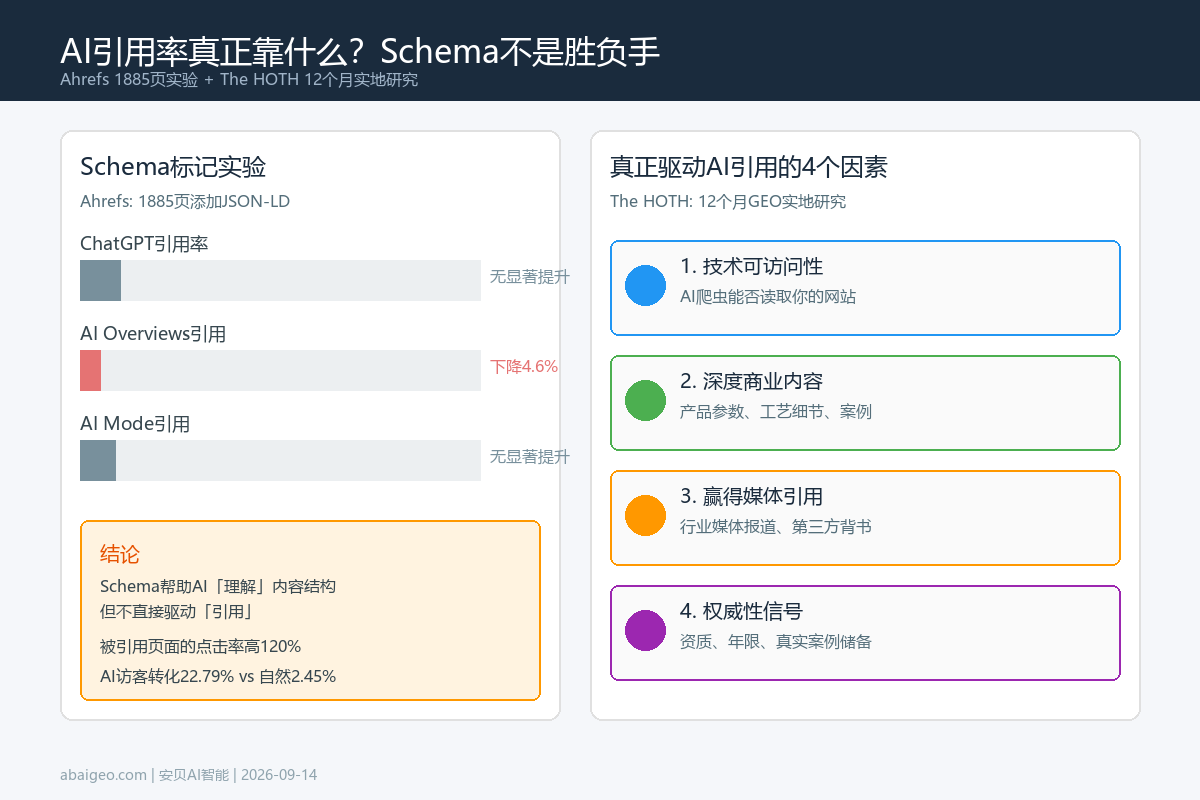
Ahrefs对1885个页面进行了对照实验:给这些页面添加JSON-LD结构化数据后,ChatGPT、Google AI Mode和AI Overviews中的引用率没有显著提升。甚至AI Overviews的引用在测试样本中还下降了4.6%。
但这不意味着Schema完全没用。关键区别在于:
- Schema帮助AI”理解”你的内容结构(机器可读性提升),但不直接驱动”引用”
- 被AI引用的页面比未被引用的页面,在AI搜索结果中的点击率高出约120%
- 真正驱动AI引用的核心因素是:技术可访问性 + 深度商业内容 + 赢得媒体引用 + 权威性信号
一家叫The HOTH的GEO服务商发布了12个月实地研究数据:在数十个GEO项目中,最显著的引用率提升来自四个基本面——技术可访问性、深度商业内容、赢得媒体、权威性——而非任何”AI搜索专属秘籍”。更有说服力的数据是:AI搜索引导的访客转化率为22.79%,而传统自然搜索访客转化率仅2.45%,差距近10倍。
这组数据对制造业工厂老板的启示:
- 别再纠结”要不要加Schema”——该加,但它不是AI引用的胜负手。把精力放在让网站技术上可被AI爬虫读取(回到第一件事)更重要
- 真正拉动AI引用的是”内容深度+权威背书+多源交叉验证”——你的工厂有没有被行业媒体报道过?有没有真实的客户案例可被AI检索?有没有多平台信息一致性?
- AI搜索访客的转化率是传统搜索的近10倍——这意味着哪怕AI搜索带来的流量不大,每一个AI引荐的询盘含金量极高
制造业工厂的9月15日行动清单
把上面三件事收拢为一份本周内可执行的行动清单:
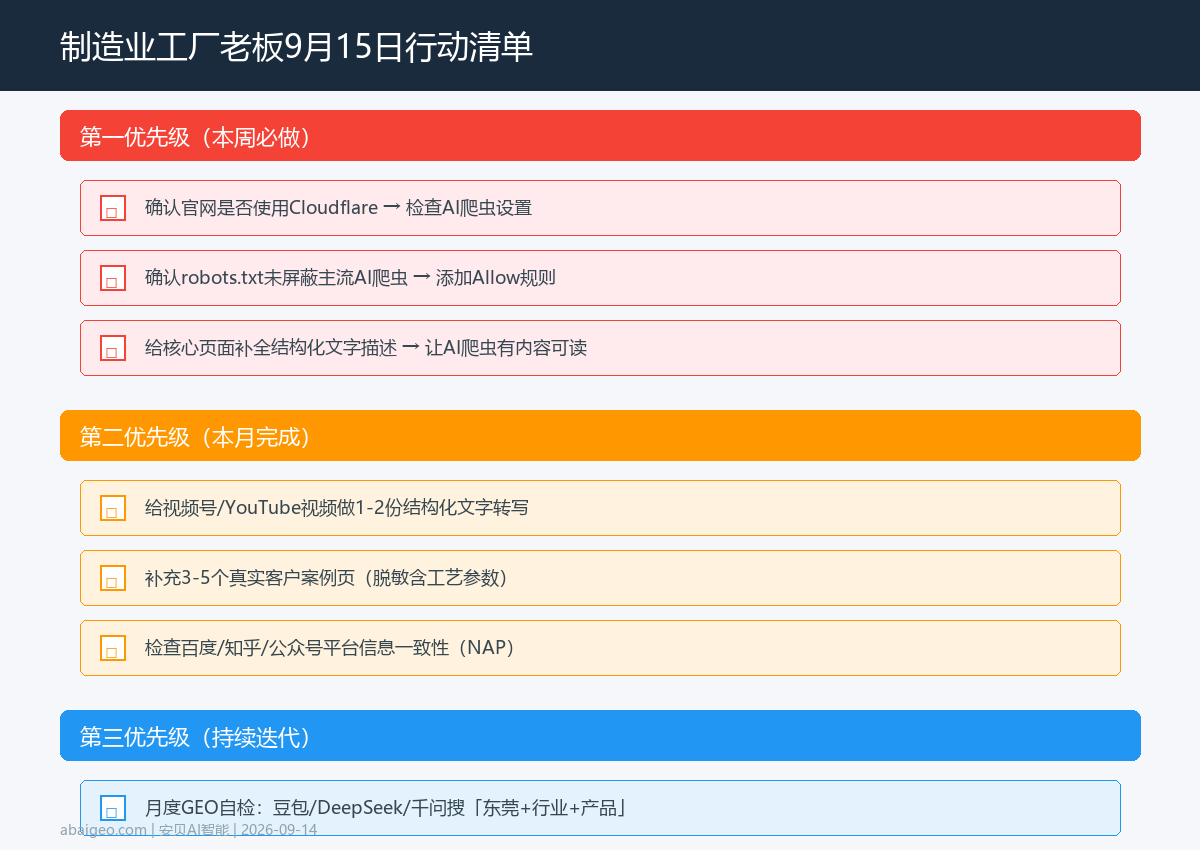
第一优先级(本周必做):
- 确认工厂官网是否使用Cloudflare → 是 → 检查AI爬虫设置 → 不要被封了还不知道
- 确认robots.txt未屏蔽主流AI爬虫 → 否 → 添加Allow规则
- 给工厂官网的核心页面(首页、产品页、关于我们)补全结构化文字描述,确保AI爬虫来了有内容可读
第二优先级(本月完成):
- 给工厂已有的视频号/YouTube视频做1-2份结构化文字转写,发布在官网对应产品页
- 补充3-5个真实客户案例页面(脱敏后),包含行业关键词和工艺参数,这是EEAT量化评分中”真实案例”维度
- 检查工厂在百度、知乎、公众号等平台的信息一致性(NAP:名称、地址、电话)
第三优先级(持续迭代):
- 建立月度GEO自检习惯:在豆包/DeepSeek/千问里搜索”东莞+你的行业+产品”,看工厂是否出现
- 如果连续2个月AI搜索无提及,重点排查信源矩阵是否够丰富(不能只有官网一个信源)
- 跟踪AI引用转化数据,把AI搜索引荐的询盘单独标记,统计转化率
写在最后
9月15日不是一个耸人听闻的截止日期,它是一个提醒:AI搜索的规则正在快速制度化,从”谁能铺量大”转向”谁的信源最可信、最结构化、最可被AI读取”。制造业工厂老板不需要成为GEO技术专家,但必须知道:你的工厂官网在AI搜索眼里是”可读、可信、可推荐”的,还是”封着、乱着、看不见”的。
Cloudflare封不封AI爬虫,取决于一个你从没检查过的设置。Schema加不加,不如先确认AI爬虫能不能进你的网站。视频内容有没有做文字转写,决定了你最有说服力的车间实拍素材在AI搜索里是完全隐形还是可以被引用推荐。
先把这三件事做了,比花大价钱做任何”AI搜索霸屏”服务都实在。
本文由安贝AI智能发布 | 东莞制造业线上推广服务商:短视频运营 + AI搜索优化(GEO)