
AI 搜索变了:DeepSeek 刚上”可溯源”、千问刚过”百万上下文”——制造业工厂老板的新内容该怎么写
如果你是东莞做 CNC 加工、注塑、五金、电子组装或者别的制造业工厂老板,过去 30 天里你应该感觉到一件事:来询盘的人少了,但来”问 AI”的人多了。
客户找你的方式变了。
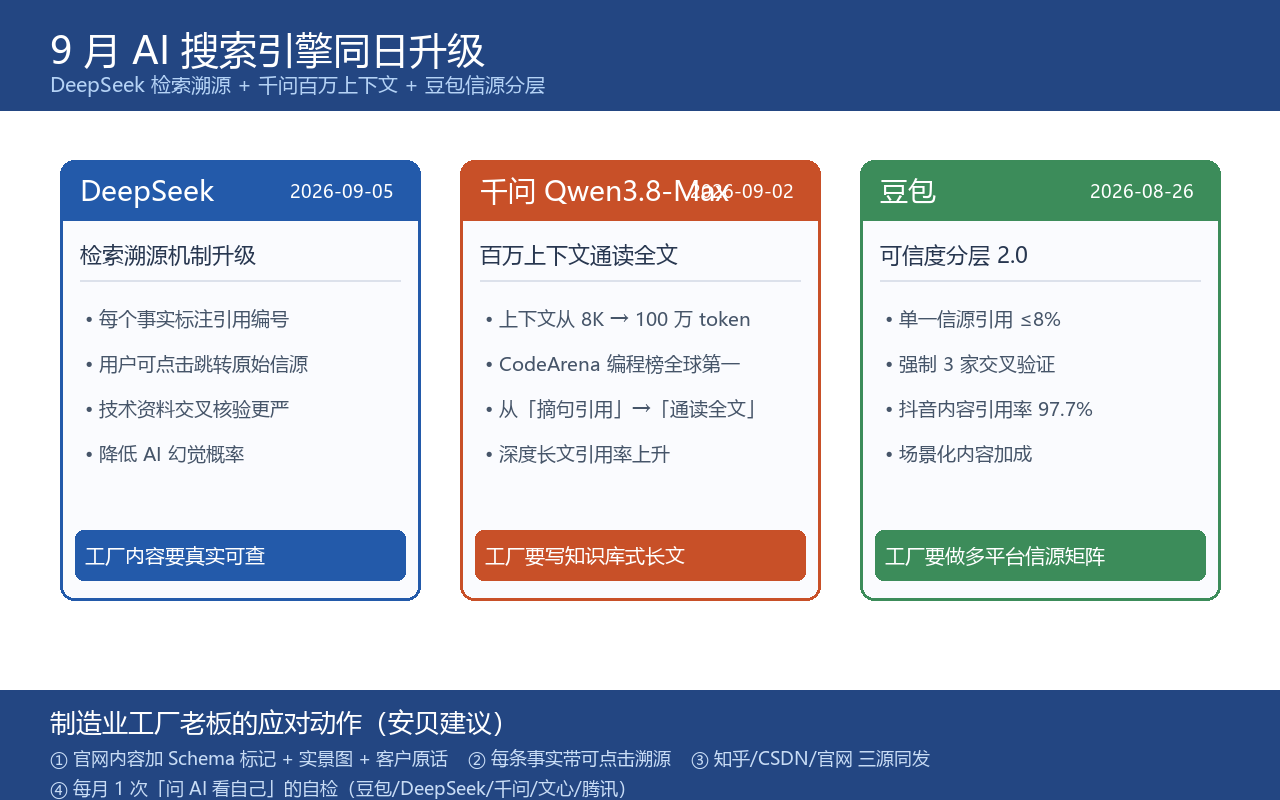
9 月 5 日,DeepSeek 网页端上线了 检索溯源机制——AI 回答里的每一条事实都开始标注引用编号,用户点一下就能跳到原始网页。9 月 2 日,阿里千问发布了 Qwen3.8-Max,上下文能力从过去的 8K 直接拉到 100 万 token,AI 从”摘句引用”升级成”通读全文”。再往前一周,豆包把可信度分层规则推到了 2.0 版本,单一信源的引用上限被压到 8%。
三件事凑在一起,意味着一个工厂老板必须接受的新事实:老一套的”铺量发稿+堆关键词”,在 2026 年 9 月之后基本就是给 AI 投毒。
这篇就讲三件事:引擎升级到底变了什么、对工厂意味着什么、以及你这周就能做的 4 个动作。
一、9 月 5 日,DeepSeek 给 AI 答案装上了”可溯源”
先看 DeepSeek 这次的更新细节。
以前 DeepSeek 回答你的问题,即使开了联网检索,也是把搜到的内容”揉”进答案里——你能看到一段完整的文字,但不知道这句话来自哪里、是不是真的、是不是过时的。
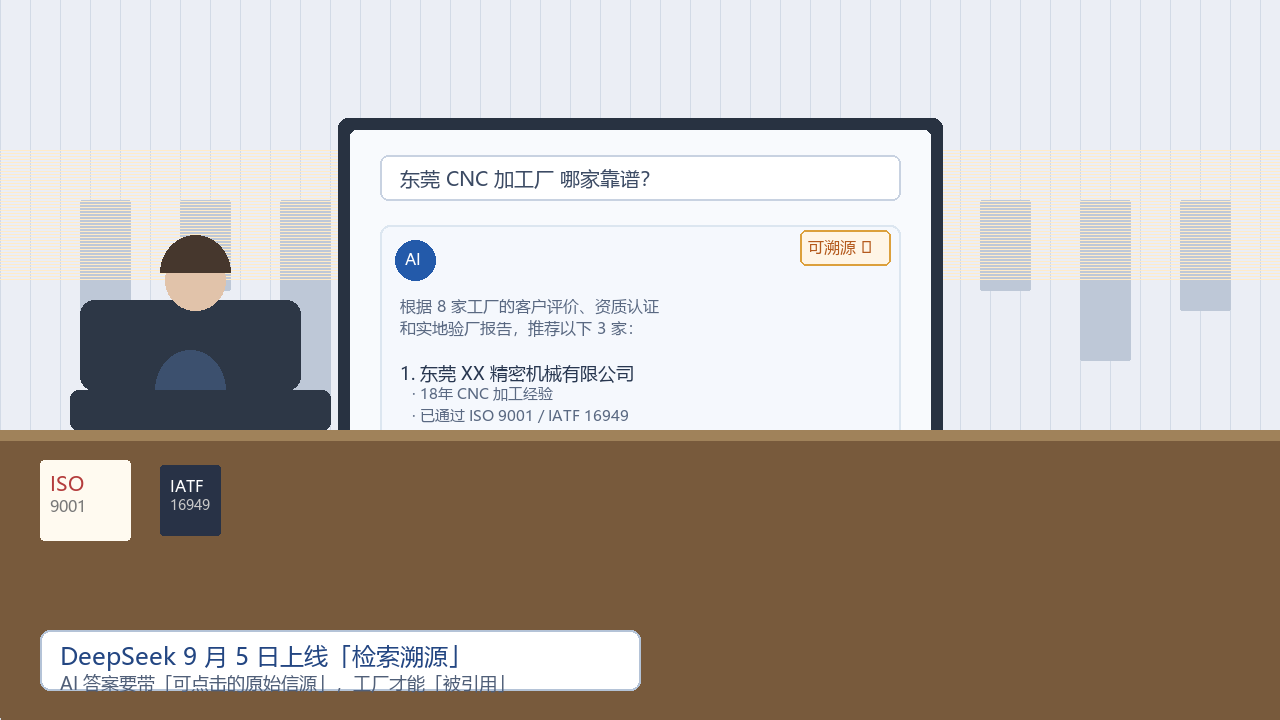
9 月 5 日的更新之后,DeepSeek 网页端每个回答里的关键事实、数据、观点,都会带一个引用编号。用户点击编号直接跳转到原始网页,自己去核验信息是不是准确。
这件事为什么对制造业工厂特别重要?因为制造业的搜索场景里,客户的决策风险高。
一个采购商在 AI 上问”东莞哪家 CNC 加工厂能做医疗器械配件”,如果 AI 的回答里没法溯源、没有第三方佐证,他大概率不会贸然下单。但反过来说——如果你的工厂有 ISO 13485、有医疗器械备案、有客户验厂报告、有车间实景图、有第三方平台背书,而且 AI 能把这些事实标出”来源:贵公司官网”、”来源:客户评价”、”来源:百度百科”,那你在 AI 答案里的”被引用”就不是一句空话,而是客户眼里真的能下单的证据。
对工厂的含义:从今天开始,你的官网、百度百科、客户评价页、第三方报道——这些内容不再是 SEO 的事,而是”被 AI 引用时能不能溯源到”的事。任何一条事实,都需要有一个”原始网页”站在背后。
二、9 月 2 日,千问把上下文拉到 100 万 token
另一件大事是阿里千问 9 月 2 日发布的 Qwen3.8-Max。
过去大模型回答问题,受限于上下文长度,往往只能”摘句”——从一篇网页里挑几个片段拼成答案。所以过去两年,工厂写 AI 优化内容的标准模板是:堆 FAQ、堆列表、堆短段落,因为这样容易被摘。
但 Qwen3.8-Max 支持 100 万 token 上下文之后,AI 有能力通读一篇 3000-5000 字的深度长文、技术白皮书、完整产品手册,再做概括总结。
这意味着什么?意味着 “知识库式长文”的引用价值,从今天起显著上升。一篇逻辑完整、数据扎实、有真实案例的 3000 字行业白皮书,比十篇东拼西凑的 500 字短文更容易成为 AI 的”权威信源”。
CNNIC 第 57 次报告显示我国生成式 AI 用户已达 6.02 亿。当亿级用户习惯”有问题先问千问”,你的工厂在千问里能不能被引用,决定了下一年能不能被客户找到。
对工厂的含义:还在写”我们公司成立于 2008 年,是一家专业从事 XX 的厂家,欢迎来电咨询”这种内容的工厂,请立刻升级。AI 现在能通读全文了,逻辑松散、缺乏数据、缺少案例的工厂简介,正在被算法过滤。
三、豆包的可信度分层 2.0,强行要求”多源交叉验证”
第三件事是 8 月 26 日豆包的「可信度分层 2.0」更新。
这次更新的核心规则有两条:
1. 单一信源引用上限 8%——意思是豆包的某个回答里,同一个域名(包括你官网)的引用比例不能超过 8%;
2. 强制 3 家交叉验证——关键事实必须有 3 个不同来源相互印证,单点内容被 AI 屏蔽的概率高达 95%。
这背后是豆包对”内容真实性”的极致要求——避免被批量铺稿污染信源池。
对工厂老板的含义很直接:单一平台、单一渠道的内容投放正在失效。
如果你的内容只发在自家官网,豆包几乎不会引用;如果你的内容发在 5 个不同平台但内容一模一样(只是改改标题),豆包会判定为”同源复制”——这种内容的引用率从过去几年的 30%+,会掉到不足 5%。
对工厂的含义:必须做多平台、多形态、差异化内容——官网、知乎、CSDN、微信公众号、抖音短视频、第三方报道,每条事实要在 3 个以上平台有交叉验证。
四、为什么制造业工厂老板要特别在意这次升级
很多工厂老板会说:”我又不做高科技,我的产品很简单,AI 引用不引用有什么关系?”
但现实是:2026 年起,制造业的 B2B 采购入口也在加速 AI 化。
数据上看三组事实:
- Averi / Forrester 2026 年报告:约 73% 的 B2B 买家在采购研究中使用 AI 工具,约 61% 的采购流程在联系供应商之前就已完成;
- Exposure Ninja 2026 年 3 月数据:AI 搜索引荐访问的转化率约 14.2%,是谷歌自然搜索(2.8%)的 5.1 倍;
- Muck Rack Generative Pulse 2026 年 5 月报告:在 25+ 行业的 AI 引用来源中,制造业是自营内容(公司官网、博客)占比最高的行业——36.6%——意味着 AI 在回答制造业问题时,更多地依赖工厂自己发的内容。
这组数据意味着两件事:
- 你的客户在 AI 上找工厂,但 AI 引用的主战场就在你自己的官网、你自己发的内容上;
- 一旦你的内容被算法过滤掉——比如被 DeepSeek 判定为”单点内容不可信”、被豆包判定为”单源超限”——你的工厂在 AI 答案里等于隐身。
换句话说:以前 SEO 失败顶多没流量,今天 GEO 失败等于”在客户最关键的决策环节缺位”。
五、4 个动作,你这周就可以开始做
针对上面所有变化,给东莞制造业工厂老板 4 条立刻能落地的动作清单:
动作 1:把官网内容改成”可溯源体”
打开你们官网的产品页、客户案例页、车间介绍页,逐条检查:
– 每一条数据(产能、规模、客户数)后面有没有”来源链接”或”时间戳”;
– 每一个客户案例有没有客户公司名+授权证明+可点击的第三方报道链接;
– 每一张车间图、每一条生产线描述,有没有具体到机型、工序、班次等可被 AI 提取的实体信息。
动作 2:把”产品简介”升级成”知识库长文”
每一条核心产品线,准备一篇 2000-3000 字的”深度技术文档”,包含:
– 工艺原理(让 AI 读得懂)
– 关键参数表格(让 AI 能摘)
– 真实客户案例+客户原话引用(让 AI 能溯源)
– 工厂实景图+车间工序图(让 AI 能识别实体)
这样的内容在 Qwen3.8-Max 时代,引用率比短段落堆叠高 3-5 倍。
动作 3:建立”多平台信源矩阵”
最少做到 3 平台同发:
– 官网(主信源)
– 知乎 / CSDN / 行业论坛(技术社区,DeepSeek 偏好)
– 微信公众号 / 头条号 / 搜狐号(媒体平台,豆包偏好)
每条关键事实在 3 个不同平台有独立内容,避免被算法判为”单源复制”。
动作 4:每月做一次”AI 自我盘点”
每月最后一周,打开 5 个主流 AI(豆包、DeepSeek、千问、文心一言、腾讯元宝),分别问:
– “东莞 XX 产品 哪家工厂好?”
– “XX 行业 有什么靠谱的供应商?”
– “XX 工艺 的认证标准有哪些?”
记录 AI 是否提到你们工厂品牌、提到几次、在第几位。然后针对没提到的、排名靠后的关键词,做下一轮内容投放。
写在最后
2026 年的 9 月,会被后来人记成”AI 搜索的范式转移月”。
DeepSeek 让每个答案都能溯源、千问让 AI 能通读长文、豆包把单一信源的价值砍到 8%——这三件事单独拿出来都是大新闻,凑在一起意味着:AI 搜索的规则已经从”看排名”全面转向”看信源质量”。
对制造业工厂老板来说,这反而是好消息——因为制造业的产品、车间、客户、案例都是”可被溯源的实物”,工厂老板只要愿意把这些”实物资产”系统化地搬到网上,AI 会比传统 SEO 时代更慷慨地把你推给客户。
但前提是:你的内容要写得让 AI 读得懂、让客户点得开、让事实经得起核验。
这是 9 月之后,所有制造业老板都该补的一课。
本文由安贝AI智能发布 | 东莞制造业线上推广服务商:短视频运营 + AI搜索优化(GEO)